Fable 5.5 vs Opus 5.5:Claude Fable、Opus、Sonnet 区别与怎么选
Fable 5.5 还没发布,现在比的是 Fable 5.1 vs Opus 5.5 vs Sonnet 5.5:价格、速度、Anthropic 跑分,以及不同任务该用哪个模型。
快速解答(2026 年 10 月 24 日更新)
- Fable vs Opus:哪个更好?
- 大多数工作选 Claude Opus 5.5。Anthropic 说它在大多数工作上达到 Fable 5.1 的水平,每 token 价格只有 40%,而且在 Anthropic 的编程和知识工作跑分上领先 Fable 5.1。需要连续几小时的 agent 任务、或 Opus 5.5 开到 high effort 仍不够的最难推理,才用 Fable 5.1。
- Sonnet 5.5 vs Opus 5.5?
- Sonnet 5.5 价格减半(每 100 万 token $2 / $10)、速度更快,GDPval-AA 与 Opus 5.5 几乎打平(1844 vs 1846)。需要持续判断的复杂开放式工作,Opus 5.5 仍更强。
- 这是 Fable 5.5 吗?
- 不是。现在的 Fable 模型是 Claude Fable 5.1,2026 年 9 月 1 日发布。截至 2026 年 10 月 24 日,Claude Fable 5.5 还没有正式发布。
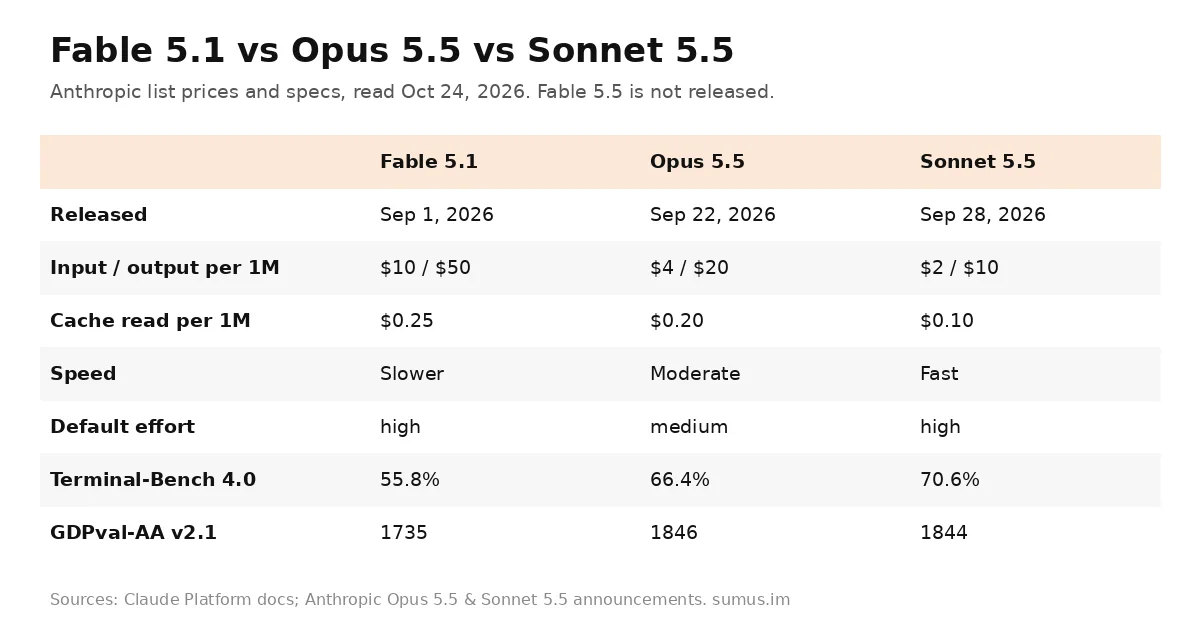
Fable vs Opus 是现在 Claude 产品线里被问得最多的问题,因为 Anthropic 在 Fable 5.1 之后三周就推出 Opus 5.5,还说它在大多数工作上和 Fable 一样好、却便宜得多。六天后 Sonnet 5.5 又上线,知识工作跑分几乎追平 Opus 5.5。下面用 Anthropic 自己的数据比较三者,并说明各自什么时候最合适。
Anthropic 的 模型选择指南 说得很直接:“Most workloads start with Claude Opus 5.5.”本对比由 Sumus AI 员工维护,产品线有变化就更新。
Fable vs Opus 一览
Fable 5.1 | Opus 5.5 | Sonnet 5.5 | |
|---|---|---|---|
定位 | 高难度推理、长时间 agent | 长时间 agent 编程和知识工作 | 速度与智能的最佳平衡 |
每 100 万 token 价格(输入 / 输出) | $10 / $50 | $4 / $20 | $2 / $10 |
缓存读取 | $0.25 | $0.20 | $0.10 |
延迟 | 较慢 | 中等 | 快 |
思考 / 默认 effort | 自适应,始终开启 / high | 自适应,始终开启 / medium | 自适应 / high |
上下文 / 最大输出 | 1M / 128K | 1M / 128K | 1M / 128K |
Terminal-Bench 4.0 | 55.8% | 66.4% | 70.6% |
CursorBench 4.0 | 51.8% | 57.8% | 55.5% |
GDPval-AA v2.1 | 1735 | 1846 | 1844 |
Humanity's Last Exam(带工具) | 65.6% | 67.7% | 64.5% |
跑分由 Anthropic 公布,来自 Opus 5.5 和 Sonnet 5.5 发布公告。三者知识截止时间都是 2026 年 6 月。
Opus 5.5 vs Fable 5.1
Opus 5.5(9 月 22 日)是 Claude 5.5 系列的第一个模型。Anthropic 的 发布公告 说它“performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5.”按 token 算,输入和输出都比 Fable 5.1 便宜 60%。
- 编程。 Opus 5.5 在 Terminal-Bench 4.0(66.4% vs 55.8%)、FrontierCode(54.4% vs 50.3%)和 CursorBench(57.8% vs 51.8%)上领先。把 HAProxy 从 C 翻译成 Rust 的测试里,两者几乎都通过全部回归测试;Opus 5.5 用了 9.5 小时(Fable 12 小时),成本低 51%。
- 研究准确度。 在一项带来源的财报测试里,18 份 Opus 5.5 报告有 16 份达到“零编造数字”标准;Fable 5.1 没有一次达到。
- 安全。 在 Gray Swan 的基准里,Opus 5.5 与 Fable 5.1 并列提示词注入成功率最低。
- Fable 5.1 仍然更强的地方。 Anthropic 称 Fable 5.1 是向所有客户开放的最强模型,推荐用于连续几小时的 agent 会话、多步骤深度研究,以及一路做到成品文档、表格或演示稿的分析。指南说:Opus 5.5 开到 xhigh 或 max effort 评测仍不够时,再换 Fable 5.1。
Anthropic 自己也说:“the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggest.”Opus 5.5 vs Fable 5.1 的实用规则:默认用 Opus,只有少数 Opus 开到 max 仍不够的任务才升到 Fable。
Sonnet 5.5 vs Opus 5.5
Sonnet 5.5(9 月 28 日)的定位是“a faster, lower-cost complement to Claude Opus 5.5.”据 Anthropic 的 Sonnet 5.5 公告,它比 Sonnet 5 快 30% 以上,每 token 价格是 Opus 5.5 的一半。
- 知识工作很接近。 GDPval-AA 1844 vs 1846;OSWorld 80.1% vs 81.8%;AA-Briefcase 1811 vs 1822。
- 终端编程领先。 Terminal-Bench 4.0 70.6%,Opus 5.5 为 66.4%;CursorBench 相差约两分以内。
- 更难的编程和推理落后。 FrontierCode 46.2%(max)vs 54.4%;Humanity's Last Exam 64.5% vs 67.7%;Chartography 无工具 61.6% vs 64.4%。
- 最适合。 范围清楚的日常任务、修 bug、精修文档、幻灯片和表格,以及设计。Anthropic 说 Opus 5.5“remains clearly stronger at complex, open-ended work requiring sustained judgment.”
早期测试者常用的搭配:让 Opus 5.5 定架构,再把实现交给 Sonnet 5.5。Anthropic 文档也支持这样配:用更便宜的执行模型,通过 advisor tool 请教 Opus。
Fable vs Opus vs Sonnet:怎么选
如果你需要 | 用 |
|---|---|
编程、agent 和知识工作的默认选择 | Opus 5.5 |
连续几小时的 agent、深度研究、Opus 开到 max 仍不够的成品演示稿或模型 | Fable 5.1 |
范围清楚的任务、文档和幻灯片,要速度和低成本 | Sonnet 5.5 |
大批量、最低延迟 | Haiku 5.5 |
换模型之前先试 effort 设置:Anthropic 说调 effort“is often a better lever than switching models.”Opus 5.5 默认 medium;Fable 5.1 和 Sonnet 5.5 默认 high。
Fable 5.5 呢?
Fable 5.5 还没出。claude-fable-5-5 之类的模型 ID 出现在一些云平台目录和开发工具里,但截至 2026 年 10 月 24 日 Anthropic 没有任何官宣。现在所有“Fable 5.5 vs Opus”的结果都是猜测。我们在 Fable 5.5 发布时间页面 跟踪相关信号,发布当天会更新这份 Fable vs Opus 对比。
在 Sumus 并排试 Fable、Opus 和 Sonnet
想知道 Fable 和 Opus 哪个适合你的工作,最快的方法是把同一个任务交给两者。在 Sumus 里,Claude Opus 5.5(默认)、Sonnet 5.5、Fable 5.1 和 Haiku 5.5 都在同一个工作区,推理 effort 最高可调到 max,100 万上下文、128K 输出,不需要单独的 Claude 账号或 API key。
先用 Opus 5.5 跑一个任务,再用 Fable 5.1 或 Sonnet 5.5 重跑,再让 GPT-6 或 Grok 队友审阅两份结果。详见 Sumus 里的 Claude 页面。
Fable vs Opus 常见问题
Claude Fable 比 Opus 好吗?
大多数任务上不是。Anthropic 说 Opus 5.5 在大多数工作上达到 Fable 5.1 的水平,并且在 Anthropic 的编程和 GDPval-AA 跑分上更高。最长、最难的 agent 和研究工作仍推荐 Fable 5.1。
为什么 Fable 5.1 比 Opus 5.5 贵?
Fable 5.1 每 100 万 token $10 / $50,Opus 5.5 是 $4 / $20。据 Anthropic,Opus 5.5 是更新、更高效的模型,服务所需算力更少。
Sonnet 5.5 和 Opus 5.5 一样好吗?
知识工作和终端编程很接近,价格只有一半。复杂开放式任务、FrontierCode 和 Humanity's Last Exam 上 Opus 5.5 仍更强。
Claude Fable 5.5 发布了吗?
没有。截至 2026 年 10 月 24 日,最新的 Fable 模型是 Fable 5.1。Fable 5.5 只有传闻,尚未官宣。
默认的 Claude 模型是哪个?
Anthropic 建议大多数工作从 Claude Opus 5.5 开始。Opus 5.5 也是 Sumus 里的默认 Claude 模型。
不用 API key 能比较 Fable 5.1 和 Opus 5.5 吗?
可以。注册 Sumus 后,Fable 5.1、Opus 5.5、Sonnet 5.5 和 Haiku 5.5 都在同一个工作区,同一个任务可以分别跑一遍。
更新记录
- — 10 月 24 日:首次发布。规格和价格来自 Anthropic Claude Platform 文档;跑分来自 Anthropic Opus 5.5(9 月 22 日)和 Sonnet 5.5(9 月 28 日)发布公告。Fable 5.5 仍未发布。